网络策略就是鉴权:用 Cilium CNP 守住「只有网关能连后端」这条线
先做一个实验。集群里跑着一套电商微服务:一个前端、一个网关、十个后端。网关负责登录,登录后把用户身份写进请求头 x-md-global-user-id,再转发给后端;后端拿到这个头就当真,直接按它查购物车。
现在我绕过网关,直接对着购物车服务发一条请求,身份头自己填一个:
curl -s -X POST https://cart.dev.test/cart.v1.CartService/GetCart \ -H 'Content-Type: application/json' \ -H "x-md-global-user-id: $(uuidgen | tr A-Z a-z)" -d '{}'{"isCartEmpty":true}200。我随手编了一个 UUID,购物车服务就把这个「用户」的购物车给我了。换成别人的真实 UUID,返回的就是别人的购物车。这条请求没经过登录、没经过任何 token 校验——因为后端的契约就是信任那个头,它假设头一定是网关放进去的。
这不是漏洞,是设计:网关做鉴权、后端做业务,身份通过内部头传递,是微服务里非常常见的分工。它成立的前提只有一条:除了网关,没有别人能连到后端。 这条前提不成立,整套鉴权就是纸糊的。
而在一个默认的 Kubernetes 集群里,这条前提恰恰是不成立的。集群网络默认全通:任何 Pod 都能连任何 Pod。一个被打穿的前端容器、一个临时起的调试 Pod、一条配错了的 HTTPRoute、一个 CI runner——都能像上面那条 curl 一样,用任意身份调后端。
上面那条 curl 之所以能通,是因为我故意为它开了一个只属于开发环境的口子,而且开之前它是被拦下来的。整篇文章就是围绕这条线展开的:谁能连到后端、怎么用 Cilium 的网络策略把它变成一条真的守得住的线、前端 / 网关 / 后端各自的策略长什么样、以及开发阶段怎么在不破坏这条线的前提下给自己开方便之门。
一、为什么是网络策略,而不是「后端也校验一遍 token」
有人会说:后端也验 JWT 不就完了?可以,但代价是每个后端都要接 Casdoor、都要缓存公钥、都要处理续期,十个服务十份重复;而且 gRPC 服务间调用、定时任务、消息消费这些没有用户上下文的调用路径还得另开一套凭据。「网关鉴权 + 内部身份头」正是为了把这些复杂度收敛到一处。
既然身份头的可信度取决于「谁能连过来」,那这件事就该由网络层回答,而且要按身份回答,不能按 IP:Pod 的 IP 随时换,副本随时扩,按 IP 写规则第二天就失效。
Cilium 的做法是给每个 Pod 按标签算一个 identity(数字 ID),策略写的是「哪个身份可以连哪个身份的哪个端口」,由 eBPF 在收包的那个 Pod 门口执行。这里有几个后面会反复用到的身份:
| 来源 | 身份 |
|---|---|
| 网关 Pod | 由标签算出,本文用它的 ServiceAccount:io.cilium.k8s.policy.serviceaccount=control-tower-gateway |
| 节点上的 kubelet(探针) | reserved:host(本节点)/ reserved:remote-node(其它节点) |
| Cilium Gateway 自己的 envoy | reserved:ingress,ID 固定为 8 |
| 集群外 | reserved:world |
按 ServiceAccount 选 Pod 而不是按 app 标签,是因为 SA 才是 Kubernetes 里的「工作负载身份」:改了 Deployment 名、换了标签方案,SA 不变,策略不用跟着改。
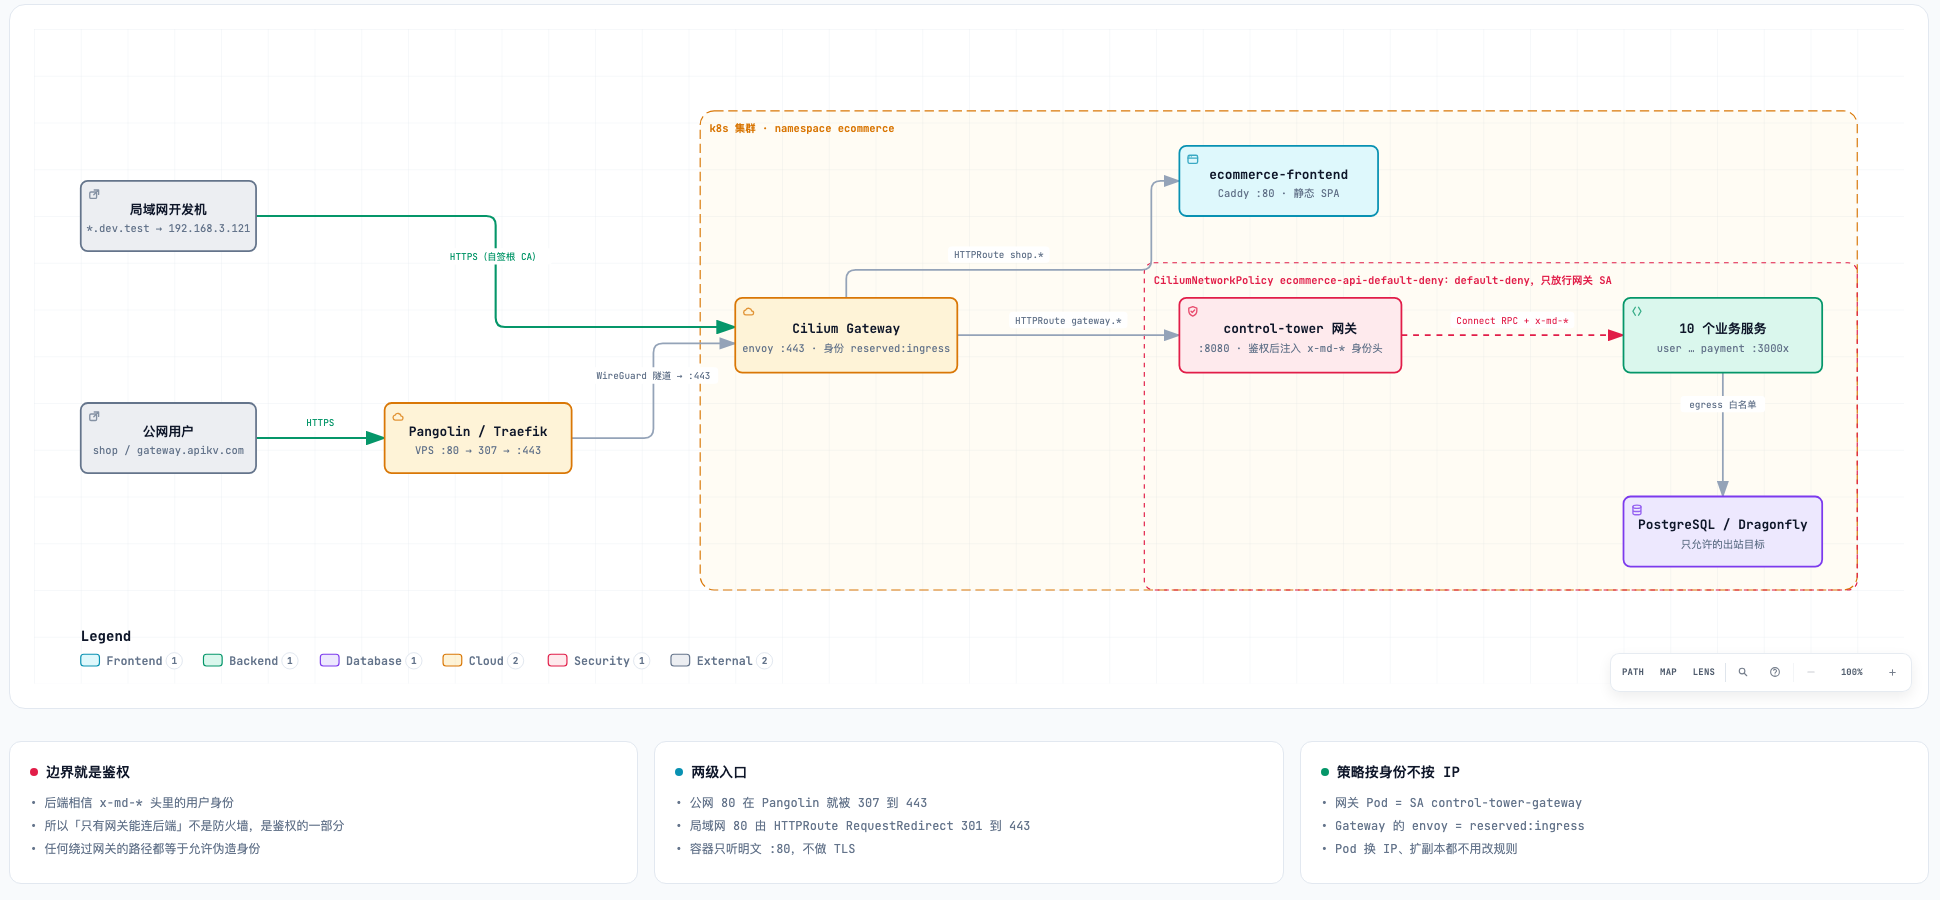
这张图就是整套系统的信任边界。红框里的东西(网关、十个后端、数据库)被一份 CiliumNetworkPolicy 罩住:默认拒绝,只放行明确列出的身份。两级入口——公网的 Pangolin/Traefik 和局域网的 Cilium Gateway——都只能把请求送到前端和网关,送不到后端。
二、安装:Cilium + Hubble
我的集群是 kubeadm 装的三节点 arm64,CNI 就是 Cilium,所以 CiliumNetworkPolicy 这个 CRD 天然就在。如果你从零开始:
# 1. cilium CLIbrew install cilium-cli          # 或从 GitHub release 下二进制
# 2. 装进集群(已有别的 CNI 要先卸干净;kube-proxy 替换与否按你的集群决定)cilium install --version 1.17.x \  --set kubeProxyReplacement=true \  --set gatewayAPI.enabled=true        # 本文的 Cilium Gateway 靠它
# 3. 等就绪cilium status --wait
# 4. Hubble —— 没有它你看不到策略在丢什么包,后面排错全靠它cilium hubble enablecilium hubble port-forward &hubble status
装好后确认三件事:
kubectl get crd | grep cilium.io # 有 ciliumnetworkpolicies.cilium.iokubectl -n kube-system exec ds/cilium -c cilium-agent -- cilium-dbg status | grep -i policykubectl -n kube-system exec ds/cilium -c cilium-agent -- cilium-dbg identity list | head最后一条会列出保留身份:1 reserved:host、2 reserved:world、8 reserved:ingress……记住 8,后面它是主角。
Gateway API 那边还要一个 Gateway 对象(我叫 cilium-gateway,在 default 命名空间,监听 80 和 443,443 挂一张 *.dev.test 的泛域名证书)。这不是本文重点,只提一句:本文所有 HTTPRoute 都只挂 sectionName: https,80 上除了跳转什么都没有。
三、策略的骨架:一份文件、一个默认拒绝、多段规则
我把整个命名空间的策略放在一份 CiliumNetworkPolicy 里,用 specs:(复数)装多段,每段选一个 ServiceAccount。这么做是为了让「谁能连谁」在一个文件里看全,而且用 YAML 锚点把公共规则(DNS、配置中心、可观测)写一次引用多次。
先看 user 服务这一段,其余九个后端结构相同:
apiVersion: cilium.io/v2kind: CiliumNetworkPolicymetadata: name: ecommerce-api-default-deny namespace: ecommercespecs: - description: "user: gateway-only ingress; Postgres, Dragonfly and Casdoor dependencies" endpointSelector: matchLabels: io.cilium.k8s.policy.serviceaccount: ecommerce-user enableDefaultDeny: { ingress: true, egress: true } # ① 这一段一旦选中 Pod,进出都默认拒绝 ingress: - fromEndpoints: &gateway # ② 只有网关能连 RPC 口 - matchLabels: k8s:io.kubernetes.pod.namespace: ecommerce io.cilium.k8s.policy.serviceaccount: control-tower-gateway toPorts: - ports: [{ port: "30001", protocol: TCP }] - fromEntities: [host, remote-node] # ③ kubelet 的探针 toPorts: - ports: [{ port: "30001", protocol: TCP }] - fromEndpoints: &consul_checker # ④ Consul 健康检查(接线保留) - matchLabels: k8s:io.kubernetes.pod.namespace: consul io.cilium.k8s.policy.serviceaccount: consul-server toPorts: - ports: [{ port: "30001", protocol: TCP }] egress: - &dns # ⑤ DNS,且开 DNS 代理 toEndpoints: - matchLabels: k8s:io.kubernetes.pod.namespace: kube-system k8s-app: kube-dns toPorts: - ports: - { port: "53", protocol: UDP } - { port: "53", protocol: TCP } rules: dns: - matchPattern: "*" - &config_center # ⑥ 按 Service 放行,不按 Pod toServices: - k8sService: namespace: config-center serviceName: config-center toPorts: - ports: [{ port: "30010", protocol: TCP }] - &otlp # ⑦ 集群外的 FQDN toFQDNs: - matchName: node3-otlp.apikv.com toPorts: - ports: [{ port: "443", protocol: TCP }] - &postgres # ⑧ 集群外的 IP,运行时注入 toCIDR: - '{{ required "global.postgresEgressCIDR is required" .Values.global.postgresEgressCIDR }}' toPorts: - ports: [{ port: "30001", protocol: TCP }] - &casdoor toFQDNs: - matchName: casdoor.apikv.com toPorts: - ports: [{ port: "443", protocol: TCP }] - &dragonfly toEndpoints: - matchLabels: k8s:io.kubernetes.pod.namespace: dragonfly app.kubernetes.io/name: dragonfly toPorts: - ports: [{ port: "6379", protocol: TCP }]逐条说为什么:
- ①
enableDefaultDeny:Cilium 的语义是「一旦有策略选中某个 Pod,该方向就默认拒绝」。显式写出来是为了让读的人不用记这条隐含规则,也为了后面「并集」那节能说清楚。 - ② 只放网关:这就是文章开头那条线。注意它同时限定了 namespace 和 SA——别的命名空间里同名 SA 不算数。
- ③
host/remote-node:readiness/liveness 探针是 kubelet 从节点网络栈发出的,不带 Pod 身份。漏了这条,Pod 永远 NotReady,而且报错长得像应用没起来。 - ⑤ DNS 代理:
rules.dns.matchPattern: "*"让 Cilium 接管 DNS 应答,后面toFQDNs才能按域名放行——Cilium 是从 DNS 应答里学到「casdoor.apikv.com 现在是哪个 IP」的。没有这条,toFQDNs静默不生效。 - ⑥
toServices:配置中心按 Service 放行,Pod 换 IP、换副本都不用改。 - ⑧
toCIDR运行时注入:Postgres 在集群外,只能按 IP。但仓库是 public 的,公网 IP 不能进 Git——这个值由部署脚本从 SSH inventory 解析后经 Helm--set-string塞进去,仓库里只有占位符。
四、应用在三类工作负载上
同一份文件里,前端、网关、后端三类工作负载的规则形状完全不同,正好对应它们的角色。
前端:只进不出
- description: "static frontend: Cilium Gateway ingress only; no runtime egress" endpointSelector: matchLabels: io.cilium.k8s.policy.serviceaccount: ecommerce-frontend enableDefaultDeny: { ingress: true, egress: true } ingress: - fromEntities: [ingress] # Cilium Gateway 的 envoy toPorts: - ports: [{ port: "80", protocol: TCP }] - fromEntities: [host, remote-node] # 探针 toPorts: - ports: [{ port: "80", protocol: TCP }] egress: [] # 静态站点没有任何出站静态 SPA 由 Caddy 托管,浏览器拿到页面后直接连公网的网关域名,Pod 自己零出站。egress: [] 配合 enableDefaultDeny 就是「一个字节都别想出去」——就算这个容器被打穿,攻击者也连 DNS 都查不了。
fromEntities: [ingress] 是重点:Cilium Gateway 的 envoy 不是普通 Pod,它的流量身份是保留的 ingress(ID 8)。想让 Gateway 能把请求送到你的 Pod,必须放行这个实体,写 Gateway 的 SA 是没用的。
SSR 的 Next.js 前端(consumer-next)多一条出站——它在服务端渲染时要调网关:
egress: - *dns - toEndpoints: *gateway toPorts: - ports: [{ port: "8080", protocol: TCP }]除此之外什么都不能连。它没有理由直连后端、数据库或公网。
网关:入口宽,出口精确
- description: "gateway: public ingress; exact control-plane/session/identity/API dependencies" endpointSelector: matchLabels: io.cilium.k8s.policy.serviceaccount: control-tower-gateway enableDefaultDeny: { ingress: true, egress: true } ingress: - fromEntities: [ingress] # 公网/局域网入口 toPorts: - ports: [{ port: "8080", protocol: TCP }] - fromEndpoints: # SSR 前端 - matchLabels: k8s:io.kubernetes.pod.namespace: ecommerce io.cilium.k8s.policy.serviceaccount: ecommerce-consumer-next toPorts: - ports: [{ port: "8080", protocol: TCP }] - fromEntities: [host, remote-node] toPorts: - ports: [{ port: "8080", protocol: TCP }] egress: - *dns - *config_center - *consul - *casdoor # 换 code / 验 token - toServices: # 链路与指标 - k8sService: { namespace: opentelemetry, serviceName: otel-opentelemetry-collector } toPorts: - ports: [{ port: "4318", protocol: TCP }] - *dragonfly # BFF session - toEndpoints: # 十个后端,逐端口 - matchExpressions: - key: app operator: In values: [ecommerce-user, ecommerce-search, ecommerce-product, ecommerce-order, ecommerce-inventory, ecommerce-cart, ecommerce-merchant, ecommerce-address, ecommerce-behavior, ecommerce-payment] toPorts: - ports: - { port: "30001", protocol: TCP } # … 30002 – 30011网关是唯一被允许连后端的工作负载,所以它的 egress 是整份文件里最长的一段,而且逐端口列出。这里有意不写 toEndpoints: {}(放行所有 Pod)——网关被打穿的后果本来就最大,它能连的东西必须一条条数得出来。
后端:入口只有网关,出口只有依赖
第三节那段就是后端的形状,十个服务各一段,差别只在端口和依赖(search 多一条到 Elasticsearch,cart 多一条到对象存储,payment 没有缓存)。共同点是 ingress 永远只有三个来源:网关、探针、Consul 健康检查。
后端之间互相不能连。这套服务目前没有服务间调用(订单核价、扣库存都还是规划中),所以策略里就没写;将来 order 要调 inventory,就在 order 的 egress 与 inventory 的 ingress 各加一条——那时策略文件本身就成了服务依赖图,比任何架构文档都准。
五、开发阶段:给自己开一个不会漏进生产的口子
现在回到开头那条 curl。日常开发我想从 Mac 直接调某个后端,不经网关——调 RPC、看 healthz、复现 bug。上面那套策略把这条路堵死了,堵得很对,但我确实需要它。
只写 HTTPRoute 是不够的
第一反应是加一条 HTTPRoute:cart.dev.test → ecommerce-cart-service:30006。加上之后:
$ kubectl get httproute ecommerce-cart-direct -n ecommerce -o json | jq '.status'Accepted=True  ResolvedRefs=True
$ curl -s -o /dev/null -w "%{http_code} %{time_total}s\n" https://cart.dev.test/healthz503 5.01s
十个服务全是 503,而且耗时都刚好 5 秒。路由层说一切正常,请求却没到达后端。Hubble 给出了答案:
$ hubble observe --verdict DROPPED --to-port 30006 --last 310.244.0.105:32769 (ingress) <> ecommerce/ecommerce-cart-deploy-…:30006 (ID:2486) policy-verdict:none INGRESS DENIED (TCP Flags: SYN)10.244.0.105:32769 (ingress) <> ecommerce/ecommerce-cart-deploy-…:30006 (ID:2486) Policy denied DROPPED (TCP Flags: SYN)源身份 (ingress)——就是 Cilium Gateway 的 envoy。它拿到 Pod IP 后发 SYN,包到 cart Pod 门口,eBPF 查策略:这个 Pod 的 ingress 只放行网关 SA、host/remote-node、consul,reserved:ingress 不在名单里,SYN 直接丢,连 RST 都不回。envoy 等不到 SYN-ACK,重试到 5 秒上游超时,回 503。503 来自 envoy,cart 根本不知道有这回事。
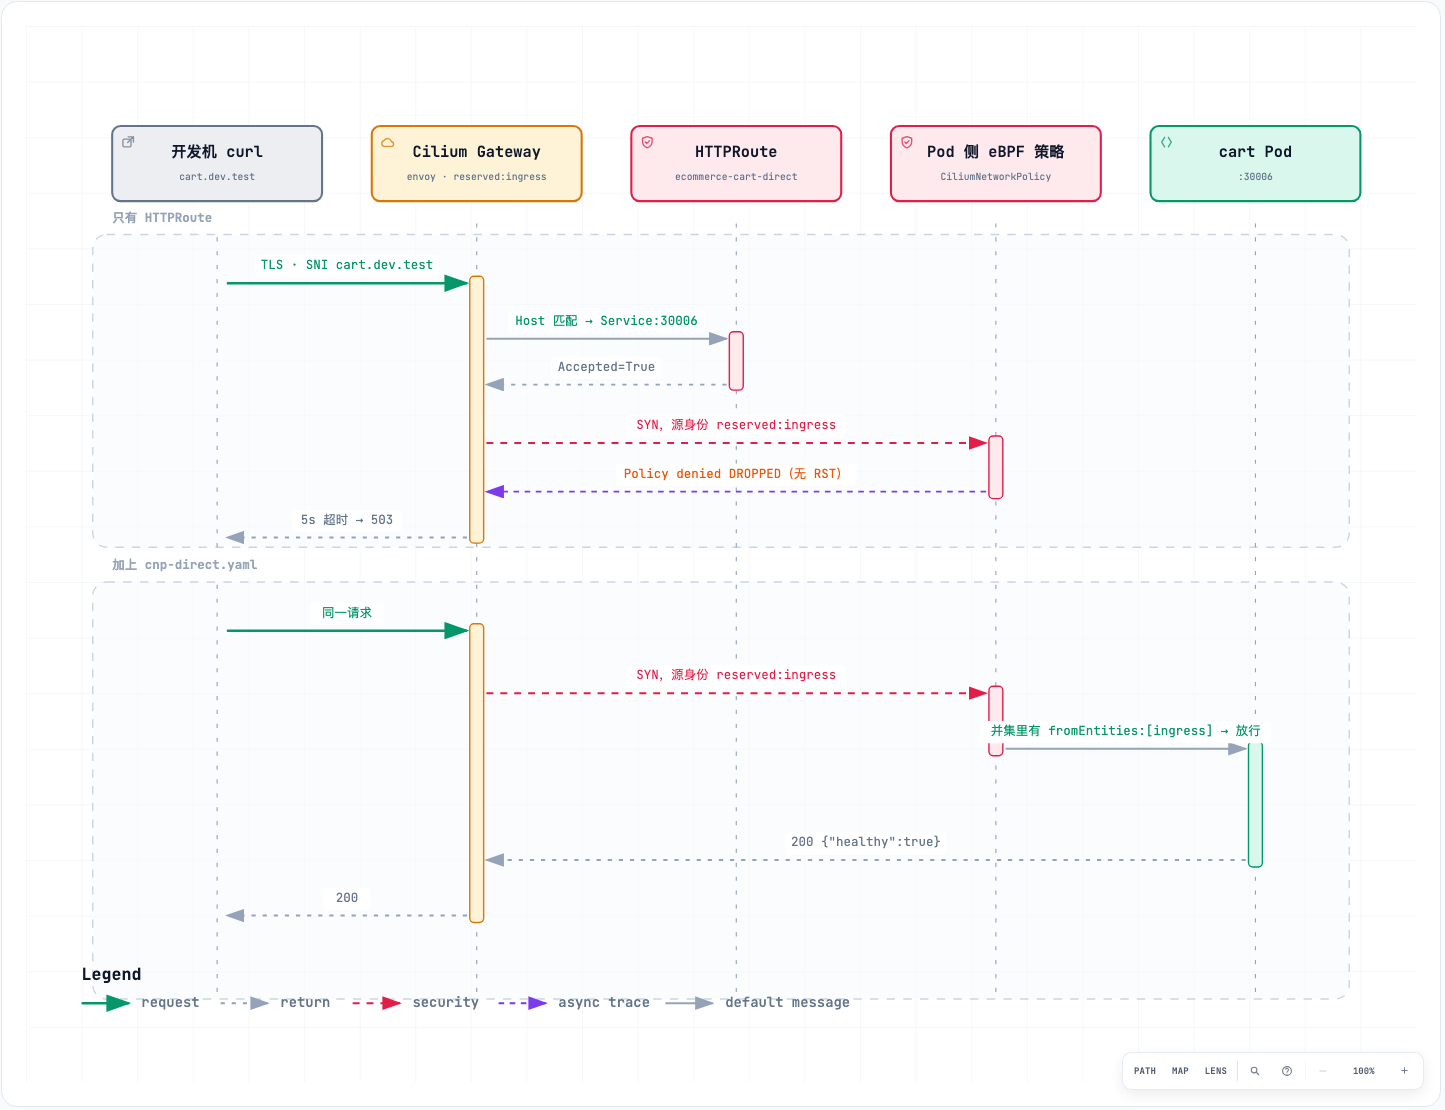
这正是策略在干活。HTTPRoute 只回答「进了 Gateway 之后去哪个 Service」,网络策略回答「包能不能进 Pod」,两层互不知情。Accepted=True 从来不检查网络策略。
成对的文件:HTTPRoute + 一份只追加的 CNP
要开这个口子,必须放行 ingress 实体到后端端口。但不能改共享的那份策略文件——它在任何环境都会 apply,改了就等于把绕过鉴权的口子带进生产。
Cilium 策略是并集:选中同一个 Pod 的所有策略叠加,任一条允许即允许。所以另写一份很小的 CNP,只做一件事:
apiVersion: cilium.io/v2kind: CiliumNetworkPolicymetadata: name: ecommerce-cart-direct namespace: ecommerce labels: app.kubernetes.io/component: dev-direct-accessspec: description: "cart: LAN direct access via Cilium Gateway (dev only, no gateway auth)" endpointSelector: matchLabels: io.cilium.k8s.policy.serviceaccount: ecommerce-cart ingress: - fromEntities: [ingress] toPorts: - ports: [{ port: "30006", protocol: TCP }]它和 HTTPRoute 放在同一个目录、同名、同开同关:
backend/services/cart/deploy/├── base/ 环境无关:deployment.yaml service.yaml└── overlays/ ├── dev/ │ ├── kustomization.yaml resources: ../../base + httproute.yaml + cnp-direct.yaml │ ├── httproute.yaml cart.dev.test → ecommerce-cart-service:30006 │ └── cnp-direct.yaml 放行 reserved:ingress → :30006 └── pre/ ├── kustomization.yaml resources: ../../base(没有那两个文件) └── patch-env.yaml DEPLOYMENT_MODE=pre、config-source-preapply 之后立刻 200;再做一个 canary 证明开门的就是这一份文件:
$ kubectl delete -f overlays/dev/cnp-direct.yaml && sleep 3 && curl … /healthz503$ kubectl apply -f overlays/dev/cnp-direct.yaml && sleep 3 && curl … /healthz200共享策略一个字没动。经网关的正常路径也没受影响(网关 SA 仍在名单里)。
让「只在 dev」成为门禁而不是自觉
口子开在 overlays/dev/ 里,overlays/pre/ 不引用它——但「不引用」是靠人记住的,人会忘。我的仓库同时维护 helm 和裸 manifest 两份部署描述,本来就有一道门禁要求两份逐字段等价;现在让它按环境各比一次:
$ scripts/verify-deploy-parity.sh✅ deploy-parity[dev] 绿:helm 与裸 manifest 渲染出同一套 76 个对象✅ deploy-parity[pre] 绿:helm 与裸 manifest 渲染出同一套 56 个对象dev 比 pre 多的 20 个对象正是十份 HTTPRoute 和十份 cnp-direct。helm 侧 values-pre.yaml 把 global.directAccess.enabled 关掉;谁要是把直连混进 pre 的任一侧,pre 那次比对就会以「只有裸 manifest 有 / 只有 helm 有」报出来。这就把「本地绕过不进生产」从一条口头约定变成了 CI 里的红绿。
开发阶段还要记住的三件事
身份头自己带。 网关不在链路上,x-md-* 头由你填,服务照信。不带时需要用户身份的 RPC 会报 invalid UUID length: 0——那不是路由坏了,是你没带头。也正因如此,这条路上任何能到 Gateway 的局域网客户端都能伪造任意用户;它只能存在于开发集群。
80 一律跳 443,容器只听明文。 公网入口 Pangolin/Traefik 的 80 挂 redirect-to-https 中间件(307);局域网入口在 Gateway 的 http listener 上挂一条 RequestRedirect 的 HTTPRoute(301)。两级入口终止 TLS,容器里的 Caddy 只听 :80,不做证书、不做跳转——这样证书只在两处轮换,容器镜像与环境无关。
集群重建,本机的根 CA 要跟着换。 我第一次打开 https://cart.dev.test 时 Firefox 报 SEC_ERROR_BAD_SIGNATURE。集群证书没问题(用集群 CA 验叶证书 OK),是 Mac 钥匙串里存着上一次集群重建前的同名根 CA:Subject 都叫 my-global-root-ca,SKI 不同。浏览器按名字找到旧的去验新签名,当然对不上。判据就是同名不同 SKI;修法是按 SHA-1 精确删旧证书再导入新的。
六、排错速查
这套东西一旦上了,故障的长相会变。下面是这次实打实碰到的几种,按症状查:
| 症状 | 大概率原因 | 怎么确认 |
|---|---|---|
503,耗时恰好等于上游超时(我的是 5s) | CNP 把 Gateway → Pod 的 SYN 丢了 | hubble observe --verdict DROPPED --to-port <port>,看源身份是不是 (ingress) |
404,响应头 server: envoy | 请求进了 Gateway 但没有 HTTPRoute 匹配这个 Host/端口(常见:路由只挂 https,你打的是 80) | kubectl get httproute -A,看 hostnames 与 sectionName |
| Pod 一直 NotReady,应用日志却正常 | 策略漏了 fromEntities: [host, remote-node],探针被丢 | Hubble 里源身份是 host |
toFQDNs 写了却不生效 | 没开 DNS 代理(rules.dns.matchPattern) | cilium-dbg fqdn cache list 是否有该域名 |
浏览器 SEC_ERROR_BAD_SIGNATURE | 本机信任库里的根 CA 与集群现行 CA 同名不同密钥 | 比 SKI / 指纹 |
| 策略「全绿」但 Pod 之间就是不通 | ipcache 身份失配、或 CES 在 Pod 换 IP 后没跟新 | cilium-dbg endpoint list 对照 Pod IP;这是另一篇的题 |
几条常用命令:
# 某个 Pod 被哪些策略选中、身份 ID 是多少kubectl -n kube-system exec <cilium-pod-on-that-node> -c cilium-agent -- cilium-dbg endpoint list
# 看丢包(一定要在 Pod 所在节点的 agent 上看,或者 hubble relay)kubectl -n kube-system exec <cilium-pod> -c cilium-agent -- hubble observe --verdict DROPPED --pod ecommerce/<pod>
# 策略 dry-run:改之前先看会动什么kubectl apply --dry-run=server -f cnp.yaml
七、收尾清单
如果只记一件事:当后端信任一个内部身份头,「谁能连到后端」就是鉴权的一部分,必须由网络策略按身份强制,而不是靠「反正在集群里」。 落地时对照这张清单:
- 每类工作负载一段策略,
enableDefaultDeny进出都开,按 ServiceAccount 选 Pod - 后端 ingress 只有:网关 SA、
host/remote-node(探针)、健康检查器 - 前端
egress: [];SSR 前端只放到网关 - 网关 egress 逐端口列出后端,不写「所有 Pod」
- Gateway API 入口用
fromEntities: [ingress],写 Gateway 的 SA 没用 - DNS 代理 +
toFQDNs处理集群外域名;集群外 IP 用toCIDR且值不进 Git - 开发用的绕过是单独一份只追加的 CNP,与它的 HTTPRoute 同目录、同开同关、只在 dev 的 overlay 里
- 有一道按环境比对的门禁,让「绕过不进生产」变成红绿而不是自觉
- Hubble 开着——没有它,被策略丢掉的包和网络故障长得一模一样